逻辑架构
逻辑架构剖析
服务器处理客户端请求
服务器进程对客户端发送请求处理过程示意图如下:
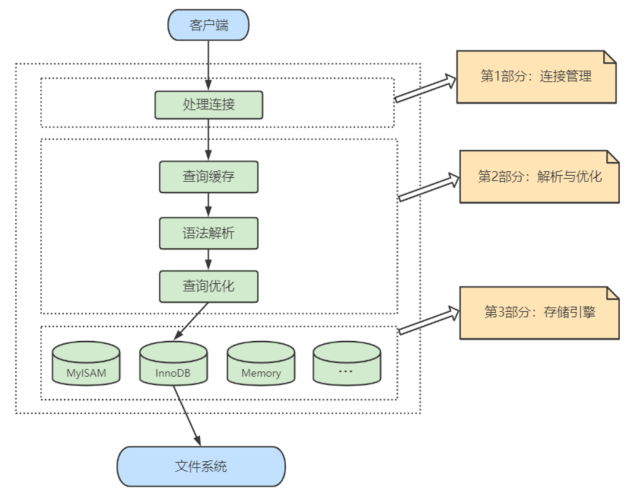
具体展开如下图:
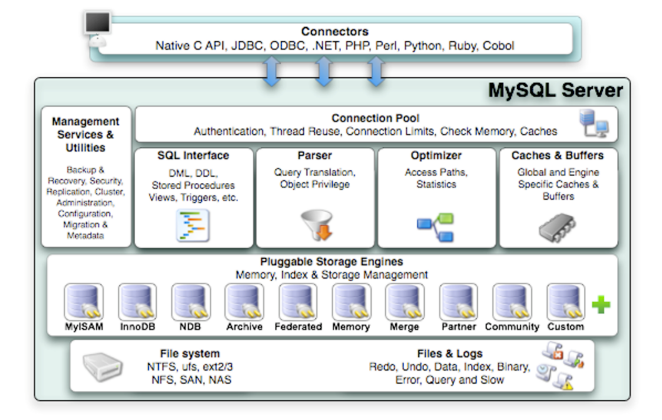
上图中的 "Caches & Buffers" 在 MySQL 8 中已舍弃。
连接器(Connectors)
第一层:连接层
系统(客户端)访问 MySQL 服务器前,做的第一件事就是建立 TCP 连接。
经过三次握手建立连接成功后,MySQL 服务器对 TCP 传输过来的账号密码做身份认证、权限获取。
① 用户名或密码不对,会收到一个"Access denied for user"错误,客户端程序结束执行
② 用户名密码认证通过,会从权限表查出账号拥有的权限与连接关联,之后的权限判断逻辑,都将依赖于此时读到的权限
TCP 连接收到请求后,必须要分配给一个线程专门与这个客户端的交互,所以还会有个线程池,去走后面的流程。每一个连接从线程池中获取线程,省去了创建和销毁线程的开销。
第二层:服务层
① SQL Interface:SQL 接口
接收用户的 SQL 命令,并且返回用户需要查询的结果。比如SELECT ... FROM就是调用 SQL Interface;MySQL 支持 DML(数据操作语言)、DDL(数据定义语言)、存储过程、视图、触发器、自定义函数等多种 SQL 语言接口。
② Parser:解析器
在解析器中对 SQL 语句进行语法分析、语义分析。将 SQL 语句分解成数据结构,并将这个结构传递到后续步骤,以后 SQL 语句的传递和处理就是基于这个结构;如果在分解构成中遇到错误,那么就说明这个 SQL 语句是不合理的。
在 SQL 命令传递到解析器的时候会被解析器验证和解析,并为其创建语法树,并根据数据字典丰富查询语法树,会验证该客户端时候具有执行该查询的权限。创建好语法树后,MySQL 还会对 SQL 查询进行语法上的优化,进行查询重写。
③ Optimizer:查询优化器
SQL 语句在语法解析后、查询之前会使用查询优化器确定 SQL 语句的执行路径,生成一个执行计划。
这个执行计划表明应该使用那些哪些索引进行查询(全表检索还是使用索引检索),表之间的连接顺序如何,最后会按照执行计划中的步骤调用存储引擎提供的方法来真正的执行查询,并将查询结果返回给用户。
它使用选取-投影-连接策略进行查询。例如:
SELECT id, name FROM student WHERE gender = '女';这个 select 查询先根据 where 语句进行选取,而不是将表全部查询出来以后再进行 gender 过滤;这个 select 查询先根据 id 和 name 进行属性投影,而不是将属性全部取出来后再进行过滤。将这两个查询条件连接起来生产最终查询结果。
④ Caches & Buffers:查询缓存组件
MySQL 内部维护着一些 Cache 和 Buffer,比如:Query Cache 用来缓存一条 select 语句的执行结果,如果能够在其中找到对应的查询结果,那么将不必再进行查询解析、优化和执行的整个过程了,直接将结果返回给客户端。
这个缓存机制是由一系列小缓存组成的,比如:表缓存、记录缓存、key 缓存、权限缓存等。
这个查询缓存可以在不同客户端之间共享。
从 MySQL 5.7.20 开始,不推荐使用查询缓存,并在MySQL 8.0 中删除。
第三层:引擎层
插件式存储引擎层(Storage Engines),真正的负责了 MySQL 数据的存储和提取,对物理服务器级别维护的底层数据执行操作,服务器通过 API 与存储引擎进行通信。不同的存储引擎具有的功能不同,这样我们可以根据自己的实际需要进行选取。
MySQL 支持的存储引擎查询:
show engines;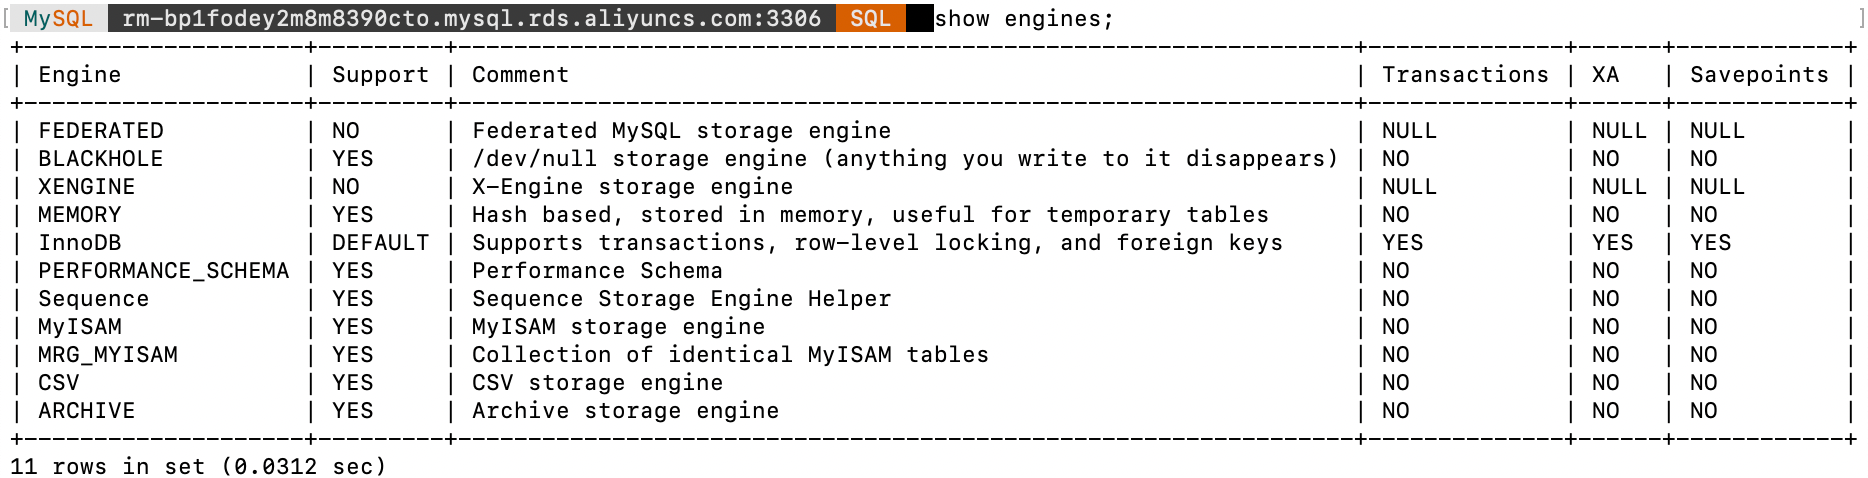
存储层
所有的数据,数据库、表的定义,表的每一行的内容,索引,都是存在文件系统上,以文件的方式存在的,并完成与存储引擎的交互。当然有些存储引擎比如 InnoDB,也支持不使用文件系统直接管理裸设备,但现代文件系统的实现使得这样做没有必要了。在文件系统之下,可以使用本地磁盘,可以使用 DAS、NAS、SAN 等各种存储系统。
小结
MySQL 架构图开篇已进行介绍,为了熟悉 SQL 执行流程,可以简化如下:
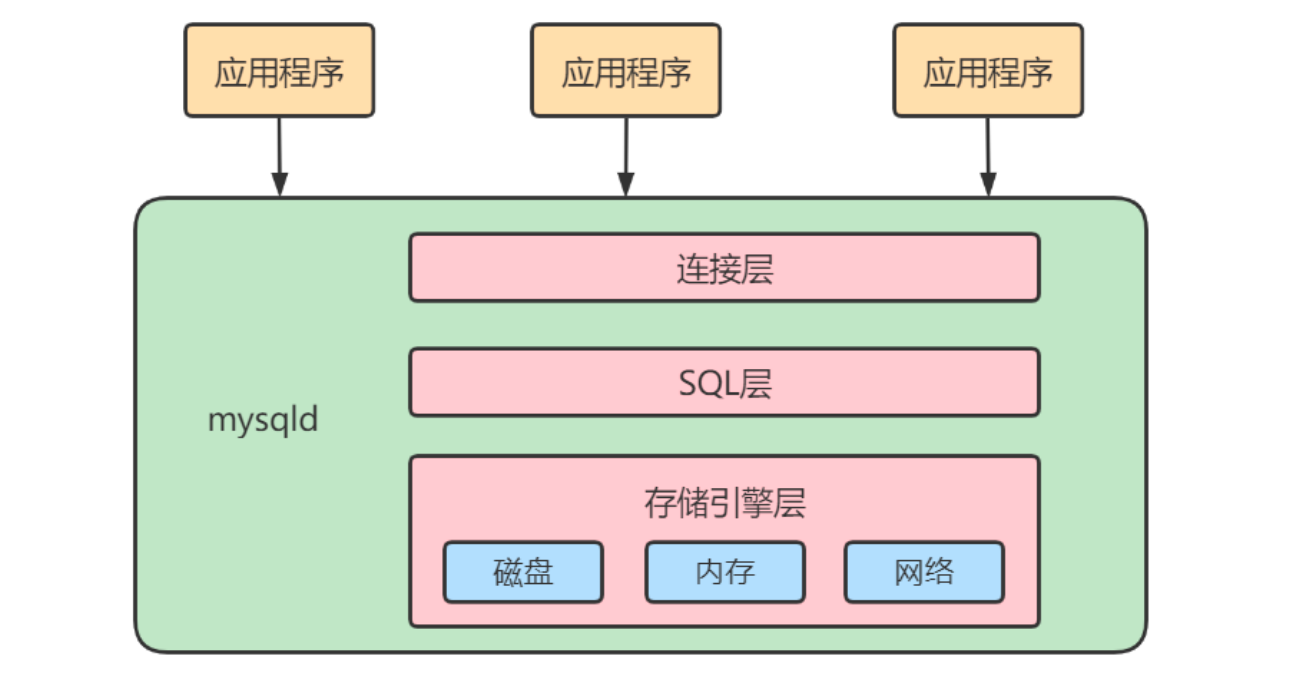
简化为三层结构:
① 连接层:客户端和服务端建立连接,客户端发送 SQL 至服务端;
② SQL 层(服务层):对 SQL 语句进行查询处理;与数据库文件的存储方式无关;
③ 存储引擎层:与数据库文件打交道,负责数据的存储和读取。
SQL 执行过程
MySQL 中的 SQL 执行流程
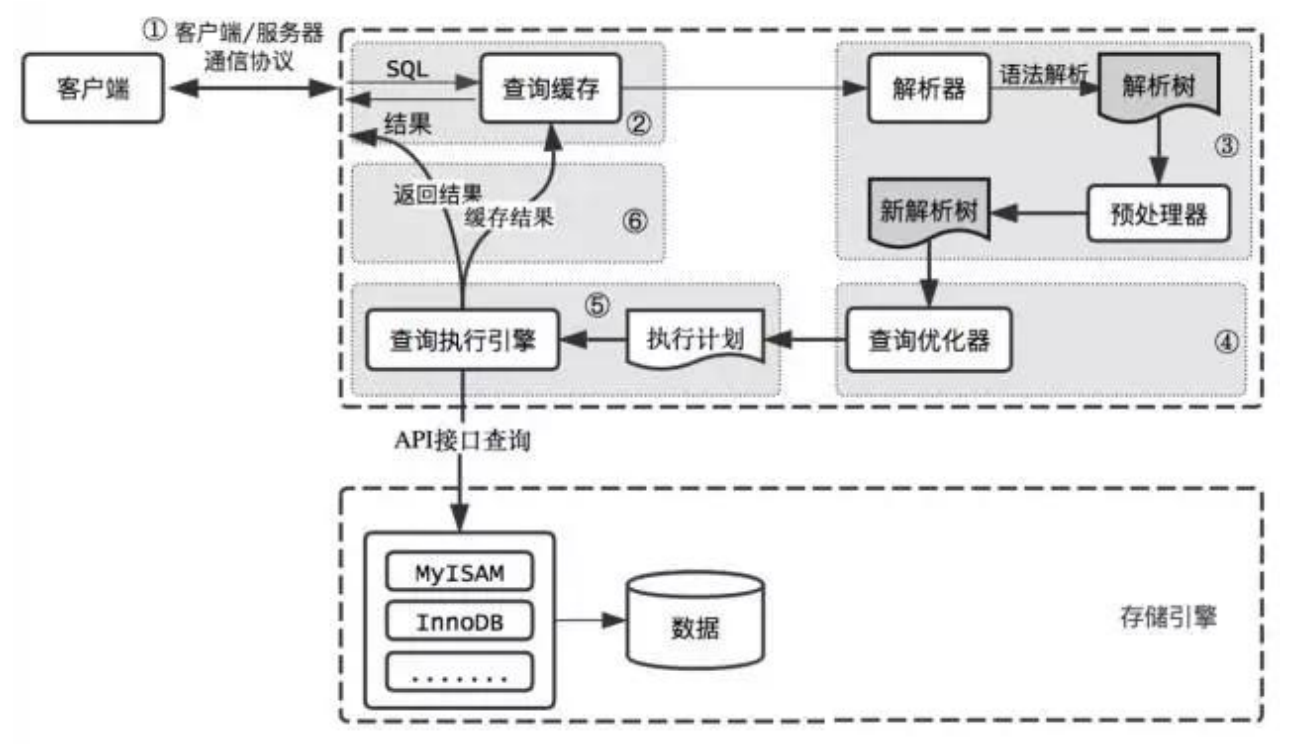
MySQL 的查询流程:
(1) 查询缓存
Server 如果在查询缓存中发现了这条 SQL 语句,就会直接将结果返回还给客户端;如果没有,就进入到解析器阶段。需要说明的是,因为查询缓存往往效率不高,所以在 MySQL8.0 之后就抛弃了这个功能。
查询缓存就是提前把查询结果缓存起来,这样下次不需要执行就可以直接拿到结果。在 MySQL 中的查询缓存,不是缓存查询计划,而是缓存查询对应的结果。 这就意味着查询匹配的鲁棒性大大降低,只有相同的查询操作才会命中查询缓存。两个查询请求在任何字符上的不同(如:空格、注释、大小写),都会导致缓存不会命中。因此 MySQL 的查询缓存命中率不高。
同时,如果查询请求中包含某些系统函数、用户自定义变量和函数、一些系统表,如:mysql、information_schema、performance_schema 数据库中的表,那这个请求就不会被缓存。以某些系统函数比如now(),每次调用都会产生新的值。
此外,既然是缓存,那就有缓存失效的时候。MySQL 的缓存系统会监测涉及到的每张表,只要改表的结构或者数据被修改,如对该表使用了INSERT、UPDATE、DELETE、TRUNCATE TABLE、ALTER TABLE、DROP TABLE或DROP DATABASE语句,那使用该表的所有高速缓存查询都将变为无效并从高速缓存中删除!对于更新压力大的数据来说,查询缓存的命中率会非常低。
(2) 解析器
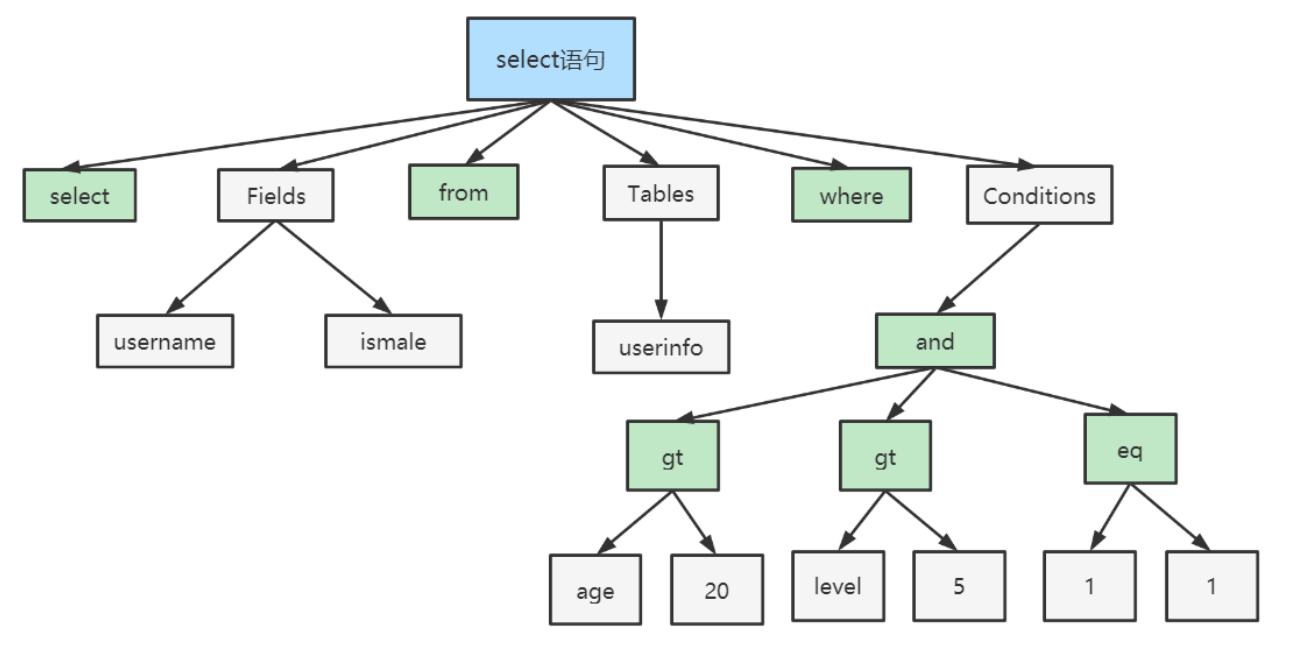
在解析器中对 SQL 语句进行语法分析、语义分析。分析器先做"词法分析",你输入的是由多个字符串和空格组成的一条 SQL 语句,MySQL 需要识别里面的字符串分别是什么、代表什么。MySQL 从你输入的"SELECT"这个关键字识别出来,这是一个查询语句,它也要把字符串"T"识别成"表名 T",把字符串"ID"识别为"列 ID"。接着要做"语法分析",根据词法分析的结果,语法分析器会根据语法规则,判断你输入的这个 SQL 语句是否满足 MySQL 语法。
解析示例
select username, ismale from userinfo
where 1 = 1 and age > 20 and level > 5;
如果 SQL 语句正确,会生成一个如下的语法树:
(3) 优化器
在优化器中会确定 SQL 语句的执行路径,比如是根据全表检索,还是根据索引检索等。在查询优化器中,可以分为逻辑查询优化阶段和物理优化阶段。
举例:如下语句是执行两个表的 join
select * from test1 join test2 using(id)
where test1.name = 'zhangwei' and test2.name = 'mysql高级课程';

① 方案一:可以先从表test1里面取出name='zhangwei'的记录的id值,再根据id值关联到表test2,
再判断test2里面name的值是否等于'mysql高级课程'。

② 方案二:可以先从test2里面取出name='mysql高级课程'的记录的id值,再根据id值关联到test1,
再判断test1里面name的值是否等于'zhangwei'。

上面两种执行方法的逻辑结果是一样的,但是执行的效率会有不同,二优化器的作用就是决定选择使用哪一个方案。
优化器阶段完成后,这个语句的执行方案就确定下来了,然后进入执行器阶段。在查询优化器中,可以分为逻辑查询优化阶段和物理查询优化阶段。
(4) 执行器 截止目前,还没有真正去读写真实的表,仅仅只是产出一个执行计划,于是进入了执行器阶段。在执行前需要判断用户是否具备权限。如果没有就返回权限错误。如果具备权限,就执行 SQL 查询并返回结果。在 MySQL 8.0 以下版本中,如果设置了查询缓存,这时会将查询结果进行缓存。
SQL 语句在 MySQL 中的流程是:SQL 语句 → 查询缓存 → 解析器 → 优化器 → 执行器
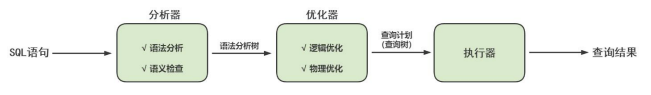
MySQL8 中的 SQL 执行原理
(1) 确认 profiling 是否开启
mysql> select @@profiling;
+-------------+
| @@profiling |
+-------------+
|           0 |
+-------------+
1 row in set, 1 warning (0.00 sec)

mysql> show variables like 'profiling';
+---------------+-------+
| Variable_name | Value |
+---------------+-------+
| profiling     | OFF   |
+---------------+-------+
1 row in set (0.00 sec)
profiling=0 代表关闭,我们需要将其打开,即设置为 1,语句:
set profiling = 1;
(2) 多次执行相同 SQL 查询
# 举例:你可以执行任何一个sql查询
mysql> select * from learn.employees;
(3) 查看 profiles 查看当前会话所产生的所有 profiles:
# 举例:你可以执行任何一个sql查询
mysql> select * from learn.employees;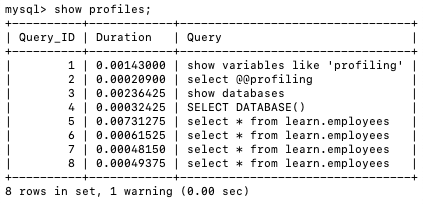
(4) 查看 profile 显示执行计划,查询程序的执行步骤:
mysql> show profile;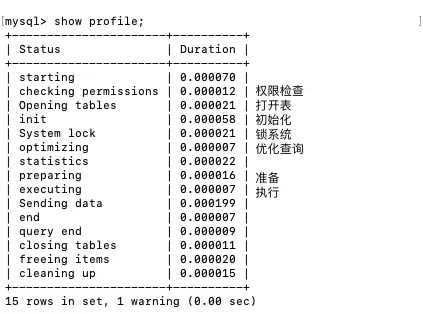
此外,可以查询指定的 Query_ID,如下:
mysql> show profile for query 7;

# 或者查询更丰富的内容
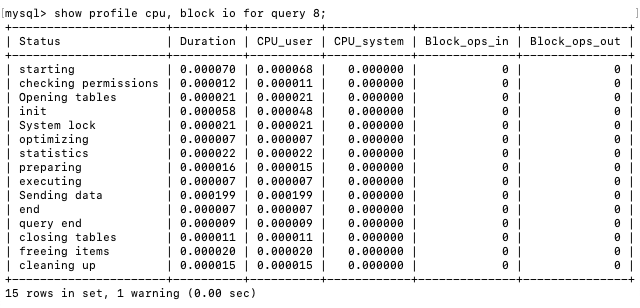
mysql> show profile cpu, block io for query 8;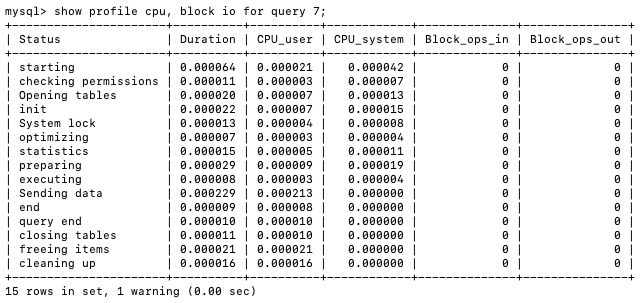
MySQL5.7 中的 SQL 执行原理
上面的语句在 MySQL5.7 中测试,可以发现查询 profile 更多内容时两个查询的查询过程是一样的,根据前面介绍的下面那次应该会使用到缓存查询,但是结果好像没有。这里需要显式开启查询缓存模式。跟着下面的步骤进行设置。
(1) 配置文件中开启查询缓存
[mysqld]
query_cache_type=1
(2) 重启 mysql 服务
[root@localhost ~] systemctl restart mysqld(3) 开启查询执行计划
mysql> set profiling=1;(4) 执行语句两次
(5) 查看 profiles
mysql> show profiles;
+----------+------------+-------------------------------+
| Query_ID | Duration   | Query                         |
+----------+------------+-------------------------------+
|        1 | 0.00746475 | select * from learn.employees |
|        2 | 0.00018675 | select * from learn.employees |
+----------+------------+-------------------------------+
2 rows in set, 1 warning (0.00 sec)
(6) 查看 profile
show profile for query 1;
show profile for query 2;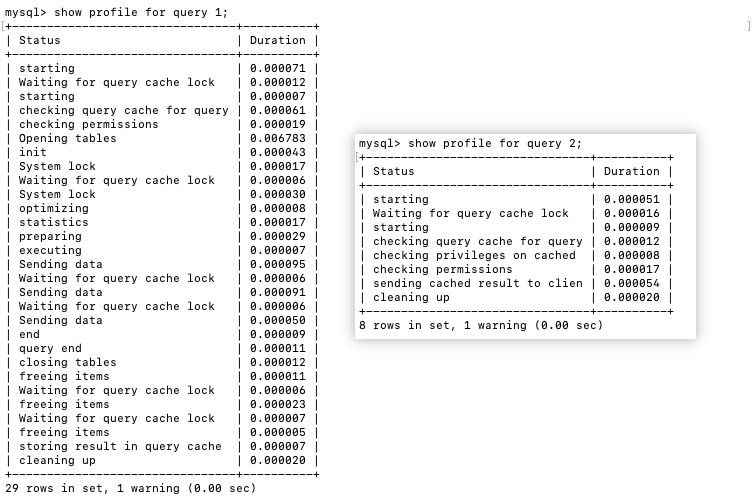
从上面可以看出第二次查询比第一次少了很多信息,可以看出查询语句直接从缓存中获取数据。
SQL 语法顺序
随着 MySQL 版本的更新迭代,其优化器也在不断地升级,优化器户分析不同执行产生的性能消耗的不同而动态调整执行顺序。
下面是经常出现的查询顺序:
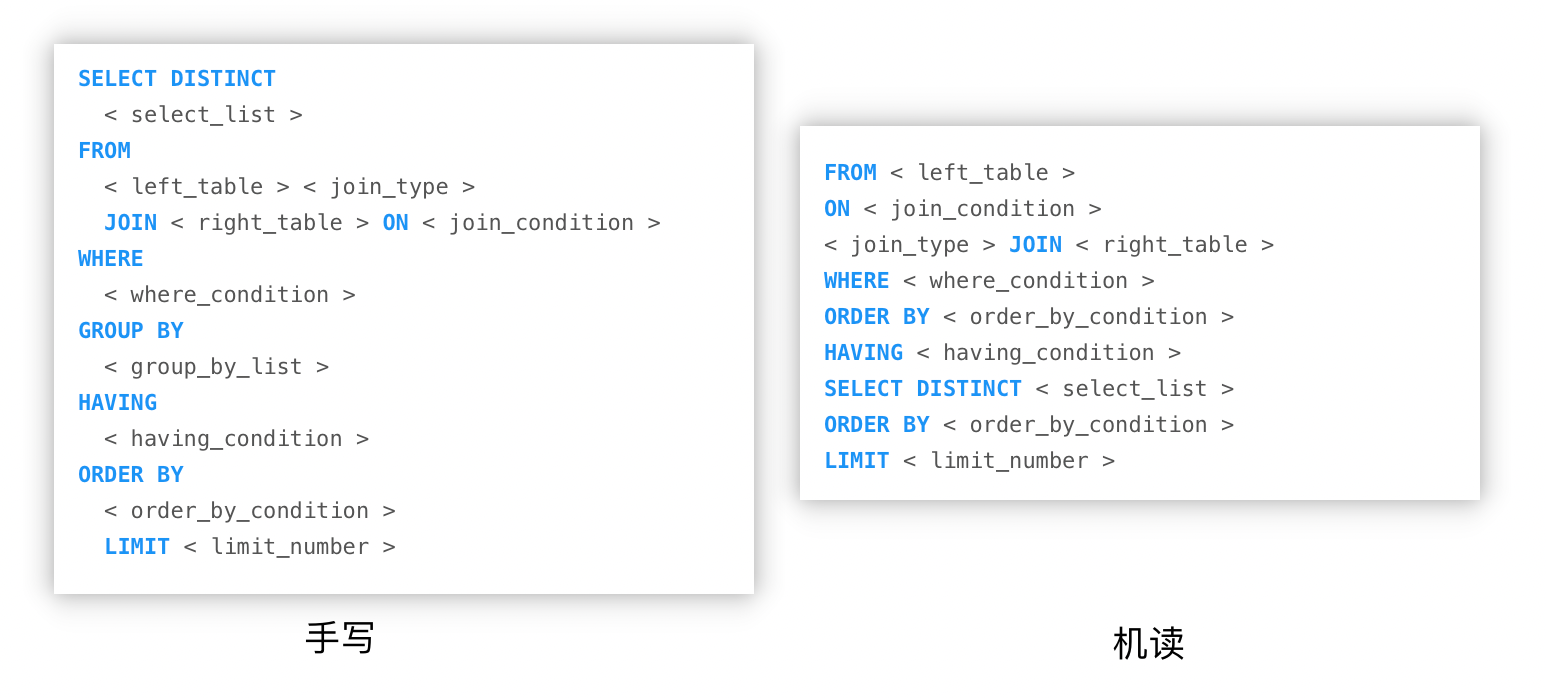
Oracle 中的 SQL 执行流程(了解)
Oracle 中采用了共享池来判断 SQL 语句是否存在缓存和执行计划,通过这一步骤我们可以知道应该采用硬解析还是软解析。
SQL 在 Oracle 中的执行过程:
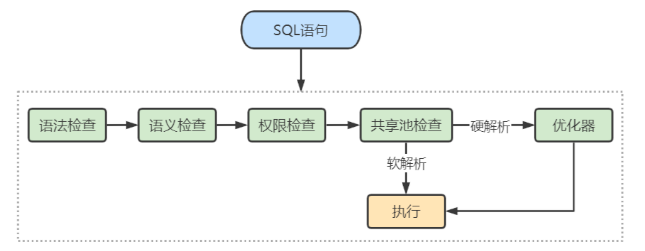
步骤:
① 语法检查:检查 SQL 拼写是否正确,如果不正确,Oracle 会报语法错误。
② 语义检查:检查 SQL 中的访问对象是否存在。比如在写 SELECT 语句时,列名写错了,系统就会提示错误。语法检查和语义检查的作用是保证 SQL 语句没有错误。
③ 权限检查:看用户是否具备访问该数据的权限。
④ 共享池检查:
共享池(Shared Pool)是一块内存池,最主要的作用是缓存 SQL 语句和该语句的执行计划。Oracle 通过检查共享池是否存在 SQL 语句的执行计划,来判断进行软解析还是硬解析。
软解析:在共享池中,首先对 SQL 语句进行 Hash 运算,然后根据 Hash 值在库缓存(Library Cache)中查找,如果存在 SQL 语句的执行计划,就执行拿来执行,直接进行"执行器"的环节
硬解析:在上述的查找中没有找到 SQL 语句和执行计划,就需要创建解析树进行解析,生成执行计划,进入"优化器"这个步骤
⑤ 优化器:优化器中就是要进行硬解析。也就是决定怎么做,比如创建解析树,生成执行计划。
⑥ 执行器:当有了解析树和执行计划之后,就知道了 SQL 该怎么执行,这样就可以在执行器中执行语句了。
共享池是 Oracle 中的术语,包括了库缓存,数据字典缓冲区等。上面已经讲到了库缓存区,它主要缓存 SQL 语句和执行计划,而数据字典缓冲区存储的是 Oracle 中的对象定义,比如表、视图、索引等对象。当对 SQL 语句进行解析的时候,如果需要相关的数据,会从数据字典缓冲区中提取。
库缓存这一个步骤,决定了 SQL 语句是否需要进行硬解析。为了提升 SQL 的执行效率,我们应该尽量避免硬解析,因为在 SQL 的执行过程中,创建解析树,生成执行计划是很消耗资源的。
你可能会问,如何避免硬解析,尽量使用软解析呢?
在 Oracle 中,绑定变量是它的一大特色。绑定变量就是在 SQL 语句中使用变量,通过不同的变量取值来改变 SQL 的执行结果。这样做的好处是能提升软解析的可能性,不足之处在于可能会导致生成的执行计划不够优化,因此是否需要绑定变量还需要视情况而定。
例如:
select * from employees where employee_id = 1001;

# 绑定变量
select * from employees where employee_id = :employee_id;
提示
这两个查询语句的效率在 Oracle 中是完全不同的。如果你在查询 employee_id = 1001 之后还会查询 1002、1003 之类的数据,那么没查询一次都会创建一个新的查询解析,而第二种方式使用了绑定变量,那么在第一次查询之后,在共享池中就会存在这类查询的执行计划,也就是软解析。
因此,我们可以通过使用绑定变量来减少硬解析,减少 Oracle 的解析工作量。但是这种方式也有缺点,使用动态 SQL 的方式,因为参数不同,会导致 SQL 的执行效率不同,同时 SQL 优化也会比较困难。
Oracle 架构图:
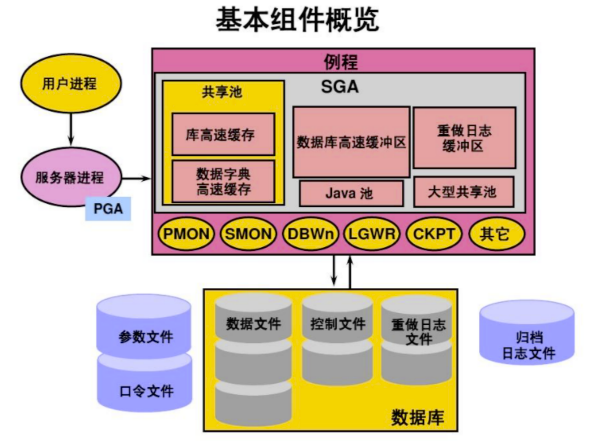
官方架构图介绍参见:https://docs.oracle.com/en/database/oracle/oracle-database/21/dbiad/
小结
Oracle 和 MySQL 在进行 SQL 的查询上面有软件实现层面的差异。Oracle 提出了共享池的概念,通过共享池来判断是进行软解析,还是硬解析。
数据库缓冲池(buffer pool)
InnoDB 存储引擎是以页为单位来管理存储空间的,我们进行的增删改查操作其实本质上都是访问页面(包括读页面、写页面、创建新页面等操作),而磁盘 I/O 需要消耗的时间很多,而在内存中进行操作,效率则会高很多,为了能让数据表或者索引中的数据随时被我们所用,DBMS 会申请占用内存来作为数据缓冲池,在真正访问页面之前,需要把磁盘上的页缓存到内存中的 Buffer Pool 之后才可以访问。
这样做的好处是可以让磁盘活动最小化,从而减少与磁盘直接进行 I/O 的时间。这种策略对提升 SQL 语句的查询性能来说至关重要。如果索引的数据在缓冲池里,那么访问的成本就会降低很多。
缓冲池 vs 查询缓存
首先说明缓冲池和查询缓存不是一个东西!
① 缓冲池(Buffer Pool)
首先我们需要了解在 InnoDB 存储引擎中,缓冲池都包含了哪些。
在 InnoDB 存储引擎中有一部分数据会放到内存中,缓冲池则占了这部分内存的大部分,它用来存储各种数据的缓存,如下图所示:
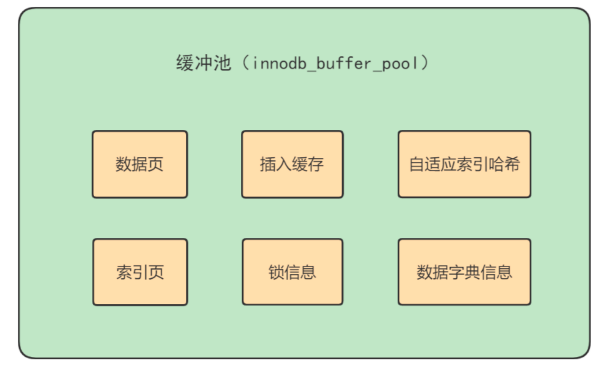
从上面我们可以看到 InnoDB 缓冲池包含了数据页、索引页、插入缓冲、锁信息、自适应索引哈希和数据字典信息等。
缓存池的重要性
(1) 缓存原则
位置 * 频次这个原则,可以帮助我们对 I/O 访问效率进行优化。
- 首先,位置决定效率,提供缓冲池就是为了在内存中可以直接访问数据。
- 其次,频次决定优先级顺序。因为缓冲池的大小是有限的,比如磁盘有 200G,但是内存只有 16G,缓冲池大小只有 1G,就无法将所有数据都加载到缓冲池里,这时就涉及到优先级顺序,会优先使用频次高的热数据进行加载。
(2) 缓冲池的预读特性
② 查询缓存
查询缓存就是提前把查询结果缓存起来,这样下次不需要执行就可以直接拿到结果。需要说明的是,在 MySQL 中的查询缓存,不是缓存查询计划,而是查询对应的结果。因为命中条件苛刻,而且只要数据表发生变化,查询缓存就会失效,因此命中率低。
缓冲池如何读取数据
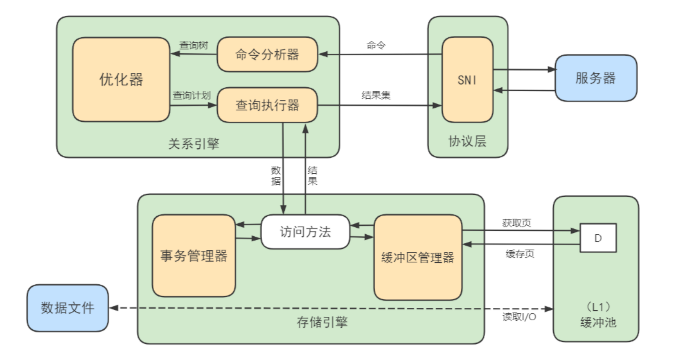
缓冲池管理器会尽量将经常使用的数据保存起来,在数据库进行页面读操作的时候,首先会判断该页面是否在缓冲池中,如果存在就直接读取,如果不存在,就会通过内存或磁盘将页面存放缓冲池中再进行读取。
缓存池数据库中的结构和作用如下图所示:
查看/设置缓冲池的大小
如果你使用的是 InnoDB 存储引擎,可以通过查看innodb_buffer_pool_size变量来查看缓冲池的大小,命令如下:
mysql> show variables like 'innodb_buffer_pool_size';
+-------------------------+-----------+
| Variable_name           | Value     |
+-------------------------+-----------+
| innodb_buffer_pool_size | 134217728 |
+-------------------------+-----------+
1 row in set (0.01 sec)你能看到此时的缓冲池大小只有134217728 / 1024 / 1024 = 128M,我们也可以修改其大小,比如修改为 256M:
set global innodb_buffer_pool_size = 268435456;

# 或者
[server]
innodb_buffer_pool_size = 268435456
多个 Buffer Pool 实例
[server]
innodb_buffer_pool_instances = 2
这样就表明我们要创建 2 个Buffer Pool实例。
查看缓冲池个数:
mysql> show variables like 'innodb_buffer_pool_instances';
+------------------------------+-------+
| Variable_name                | Value |
+------------------------------+-------+
| innodb_buffer_pool_instances | 1     |
+------------------------------+-------+
1 row in set (0.01 sec)
那每个 Buffer Pool 实例实际占用多少内存空间呢?可以这么计算:innodb_buffer_pool_size / innodb_buffer_pool_instances,也就是用总共的大小除以实例个数。
引申问题
Buffer Pool 是 MySQL 内存结构中十分核心的一个组成,你可以先把它想象出一个黑盒子。
黑盒子的更新数据流程:
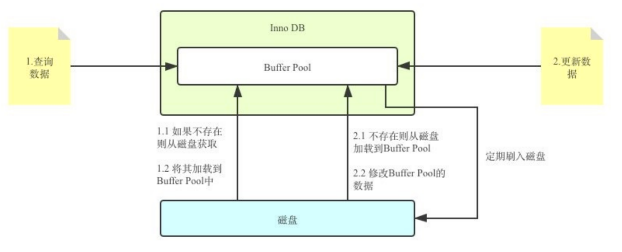
假设数据更新到一半突然发生错误了,想要回滚到更新之前的版本,该怎么办?连数据持久化的保证、事务回滚都做不到还谈什么崩溃恢复?
答: Redo Log & Undo Log